データ分析や臨床試験、マーケティングリサーチの現場において、「とりあえずt検定にかけておけば安心」と思い込んでいないでしょうか。実際の測定データやアンケート結果は、必ずしも教科書通りの美しい山型(正規分布)を描くとは限りません。分布の歪みや極端な外れ値を無視して不適切な検定を強行すると、誤った有意差を導き出すリスクを招きます。
母集団の分布に特定の前提を求めない「ノンパラメトリック検定」は、実務データの多くが抱える不都合な真実をカバーする極めて重要な統計手法です。本稿では、パラメトリック検定との違いから、データの性質に応じた明確な選び方、EZRやPythonでの実践手順までを網羅的に整理してお伝えします。
📌 【この記事の重要ポイントまとめ】
- 要点1:正規分布に従わないデータや外れ値を含むサンプルでは、パラメトリック検定ではなくノンパラメトリック検定を選択するのが鉄則。
- 要点2:群数(2群か3群以上か)とデータの対応関係(対応あり・なし)によって、マン・ホイットニーのU検定やクラスカル・ウォリス検定などを正確に使い分ける。
- 要点3:EZRやPythonを活用すれば、事前の正規性検定(シャピロ・ウィルク検定)から実検定の集計まで迷わずスムーズに実行できる。
【基礎知識】ノンパラメトリック検定とは?パラメトリック検定との決定的な違い
統計的仮説検定は、大きくパラメトリック検定とノンパラメトリック検定の2つに大別されます。この両者の根本的な違いは、「データが特定の確率分布(主に正規分布)に従っているという前提を置くかどうか」という点にあります。
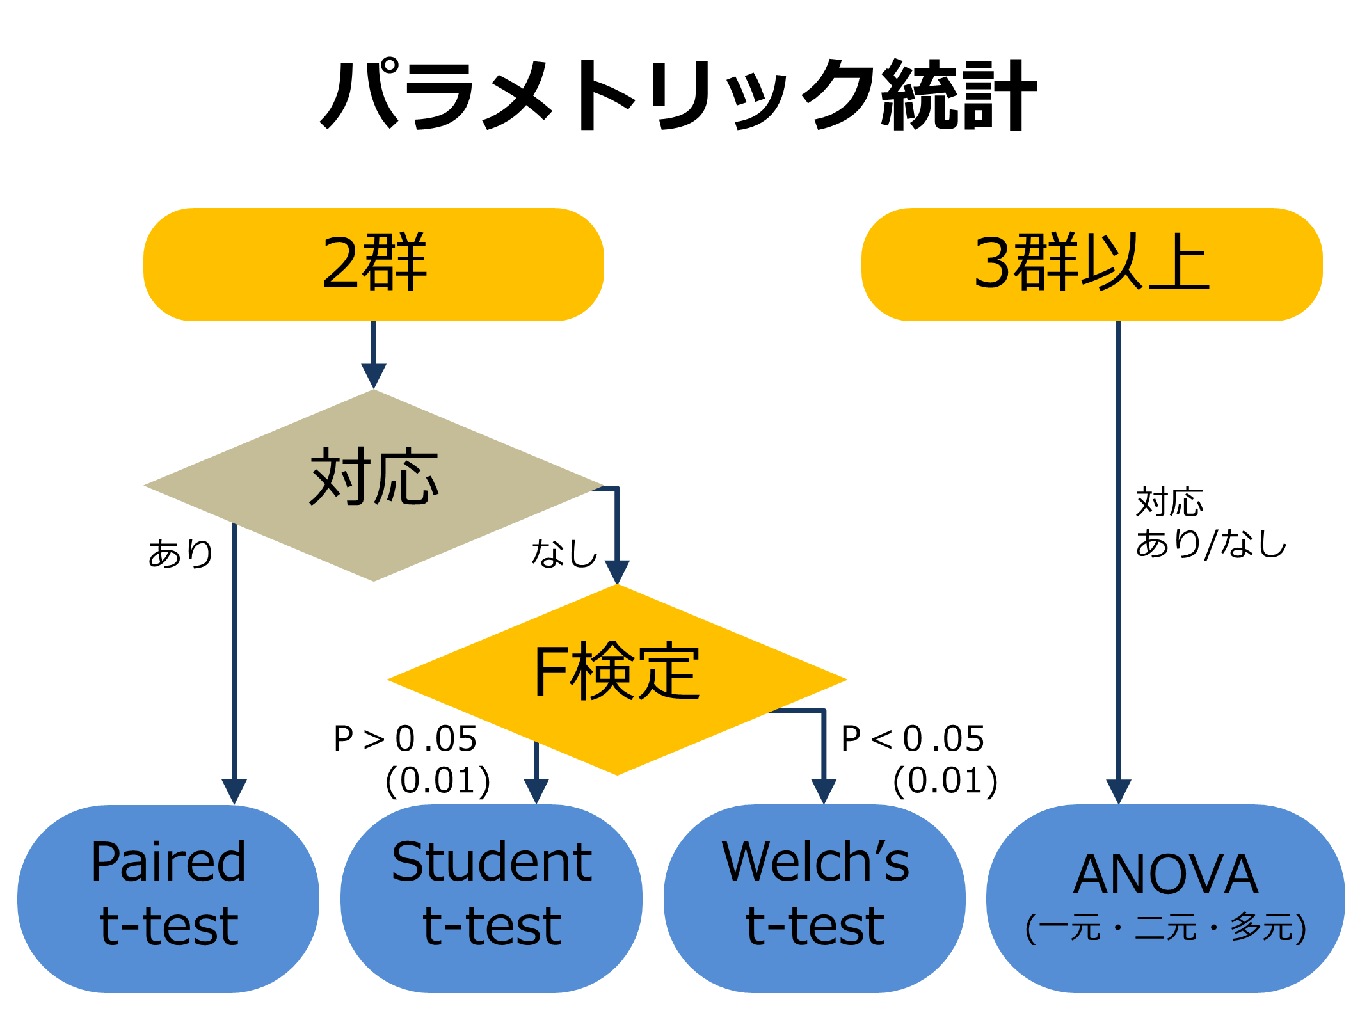
パラメトリック検定(代表例:Studentのt検定、分散分析など)は、母集団が正規分布に従うことを前提とし、データの「平均値」や「分散」といった要約統計量を用いて検定を行います。前提条件が満たされていれば統計的検出力(真の差を正しく検出する力)が高いという大きなメリットがあります。
対してノンパラメトリック検定は、母集団の分布形状を問いません。数値をそのまま計算に使うのではなく、データを小さい順に並べ替えた「順位(ランク)」や「頻度」に変換して検定を行うのが特徴です。この仕組みにより、極端な外れ値の影響を直接受けにくく、分布が左右に大きく歪んでいるデータでも安定した検証が可能になります。
【判断基準】ノンパラメトリック検定を使うべき決定的な理由と選び方フロー
「どちらの検定を使うべきか」という問いに対して、現場で最も重視されるのがt検定との使い分け基準です。安易なパラメトリック検定の適用は第一種の過誤(偽陽性)や検出力低下を招くため、明確な判断ロジックを押さえておく必要があります。
ノンパラメトリック検定を選択すべき主な状況は以下の通りです。
1. データが正規分布に従っていない場合
ヒストグラムやQ-Qプロットでの視覚的確認に加え、正規性検定(シャピロ・ウィルク検定)などを実施し、正規性が明確に棄却された場合はノンパラメトリック検定が第一選択となります。
2. サンプルサイズが極端に少ない場合
サンプルサイズが少ない小規模試験(各群数例〜十数例程度)では、正規性の検証自体が難しく、1つの外れ値で平均値が大きくブレてしまいます。中心極限定理による正規近似も期待できないため、安全側に倒してノンパラメトリック手法を適用するのが堅実です。
3. 順序尺度(アンケートの5段階評価など)を扱う場合
「非常に満足(5)」から「非常に不満(1)」といったリッカート尺度は、数値間の間隔が等しいとは言えない順序尺度です。これらを平均値で比べるのは統計学的に危うく、順位情報に基づくノンパラメトリック検定が適しています。
【手法一覧】2群・多群・相関分析の主要検定をわかりやすく整理
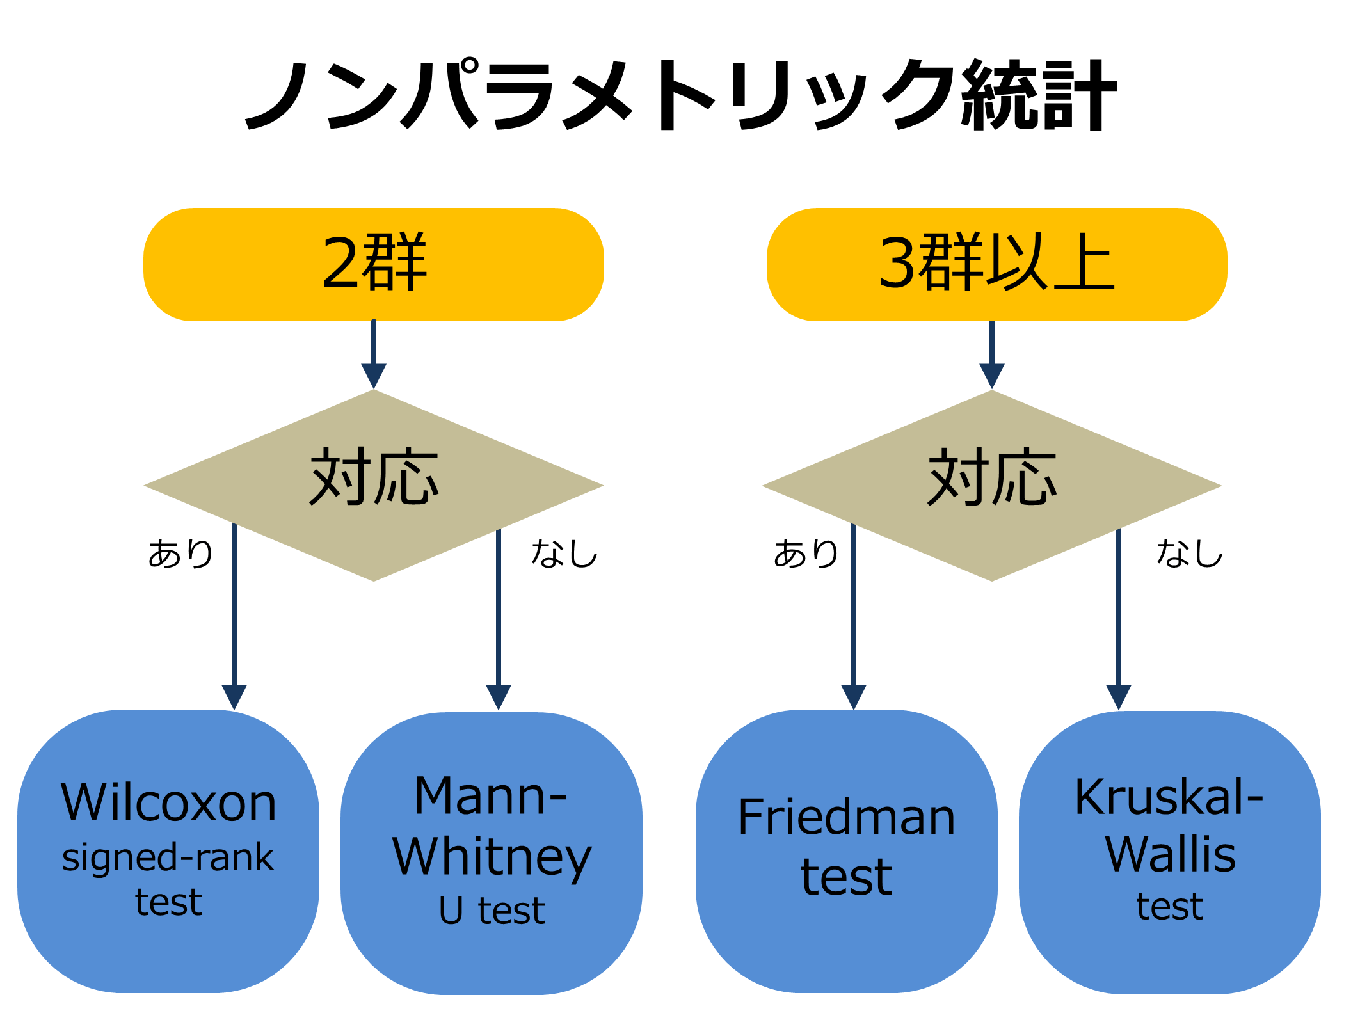
ノンパラメトリック検定には、パラメトリック検定の各手法に対応する代替手法が用意されています。有意差検定の選び方を迷わないよう、比較する群数と「対応の有無」で整理した対応表を確認しておきましょう。
| 検定の目的 | パラメトリック手法 | ノンパラメトリック手法 |
|---|---|---|
| 2群の比較(対応なし) | 対応のないt検定 | マン・ホイットニーのU検定(ウィルコクソンの順位和検定) |
| 2群の比較(対応あり) | 対応のあるt検定 | ウィルコクソンの符号順位検定 |
| 3群以上の比較(対応なし) | 一元配置分散分析(ANOVA) | クラスカル・ウォリス検定 |
| 3群以上の比較(対応あり) | 反復測定分散分析 | フリードマン検定 |
| 2変数間の関連・相関 | ピアソンの積率相関係数 | スピアマンの順位相関係数 |
2群比較における順位和検定をわかりやすく言えば、「両群のデータを混ぜて昇順に並べ、順位の合計値に偏りがあるかを確かめる手法」です。対応のないデータにはマン・ホイットニーのU検定、同一被験者の前後比較など対応があるデータにはウィルコクソンの符号順位検定を使い分けます。
また、3群以上の場合はクラスカル・ウォリス検定を行い、有意差が認められた段階でノンパラメトリック対応の多重比較補正(Bonferroni補正やDunn検定など)へ進む流れが基本です。
【実践手順】EZRとPythonによるノンパラメトリック検定の実装ステップ
実際の解析環境として、医療統計で広く使われるGUIソフト「EZR」と、データサイエンスで標準的な「Python」における実行手順を簡潔に紹介します。
EZRでの操作手順
マウス操作で直感的に解析できるEZRでは、以下のステップで進めます。
1. メニューの「統計解析」→「連続変数の解析」を選択。
2. 2群の比較なら「2群の比較 (Mann-WhitneyのU検定)」、対応ありなら「対応のある2群の比較 (Wilcoxonの符号付順位検定)」をクリック。
3. 目的変数とグループ分け変数を指定して「OK」を押すだけで、p値および中央値(四分位範囲)が出力されます。
Pythonでの実装例(SciPyライブラリ)
Pythonを用いる場合は、`scipy.stats`モジュールを活用するのが最も手軽です。
from scipy import stats
stat, p_val = stats.shapiro(data_groupA)
print(f"正規性検定 p値: {p_val}")
# マン・ホイットニーのU検定(対応なし2群)
u_stat, p_val_u = stats.mannwhitneyu(data_groupA, data_groupB, alternative='two-sided')
print(f"U検定 p値: {p_val_u}")
# スピアマンの順位相関係数
rho, p_val_rho = stats.spearmanr(x, y)
print(f"スピアマン相関係数: {rho}, p値: {p_val_rho}")
【注意点】ノンパラメトリック検定を扱う上での落とし穴
万能に見えるノンパラメトリック検定ですが、適用にあたっては注意すべき側面もあります。
第一に、「正規分布しているデータに対して使うと、検出力がわずかに低下する」という点です。真に正規分布に従う集団に対し、十分なサンプルサイズがあるにもかかわらずノンパラメトリック検定を適用すると、本来検出できるはずの有意差を見落とす(第二種の過誤)可能性があります。
第二に、ノンパラメトリック検定は「平均値の差」を直接検定しているわけではない点です。基本的に「中央値の差」または「分布全体の順位の偏り」を見ているため、レポートや論文を執筆する際は、平均値±標準偏差(SD)ではなく、中央値(四分位範囲:IQR)を併記するのが作法となっています。
【ノンパラメトリック検定】に関するよくある質問(FAQ)
Q1:サンプルサイズが小さければ、無条件でノンパラメトリック検定を選んで良いですか?
A1:実務上は無難な選択肢となります。サンプルサイズが小さい(各群n < 10程度)場合、正規性検定自体の検出力が低く、正規分布から外れていても検定で「正規性あり」と誤判定されやすいためです。ただし、背景理論から正規性が明確に保証されている分野であればパラメトリック検定を使う場合もあります。
Q2:結果の表記で「平均値」を記載してはいけませんか?
A2:平均値を参考情報として記載すること自体は禁止されていませんが、検定の主眼が順位に基づいているため、代表値としては中央値と四分位範囲(25%点〜75%点)を主軸に記述するのが標準的です。
Q3:順序尺度データ(アンケート結果など)をt検定するのは完全に誤りですか?
A3:マーケティング実務等で便宜上t検定が行われるケースは散見されますが、統計学的な厳密さを求められる学術論文や治験データでは査読で指摘されるリスクが高くなります。順序尺度にはマン・ホイットニーのU検定やスピアマンの順位相関を用いるのが安全です。
まとめ:データ特性の見極めが分析の信頼性を左右する
ノンパラメトリック検定は、現実世界の歪んだデータや極端な外れ値から分析結果を守るための不可欠なツールです。「正規性があるか」「対応があるか」「群数はいくつか」というステップを丁寧に辿ることで、導き出される結論の客観性と説得力は格段に高まります。
ツールやプログラミング言語が発達した現代だからこそ、ボタンひとつで検定を走らせる前に、手元のデータ構造を正しく見極めるリテラシーを維持していきましょう。 (出典: ノン パラメトリック 検定(Yahoo!ニュース))
関連フォトギャラリー
ノン パラメトリック 検定
ノン パラメトリック 検定
